Integração
de recursos de GPU, DRAM e SSD para acelerar a inferência e a implementação de
IA em ambientes corporativos
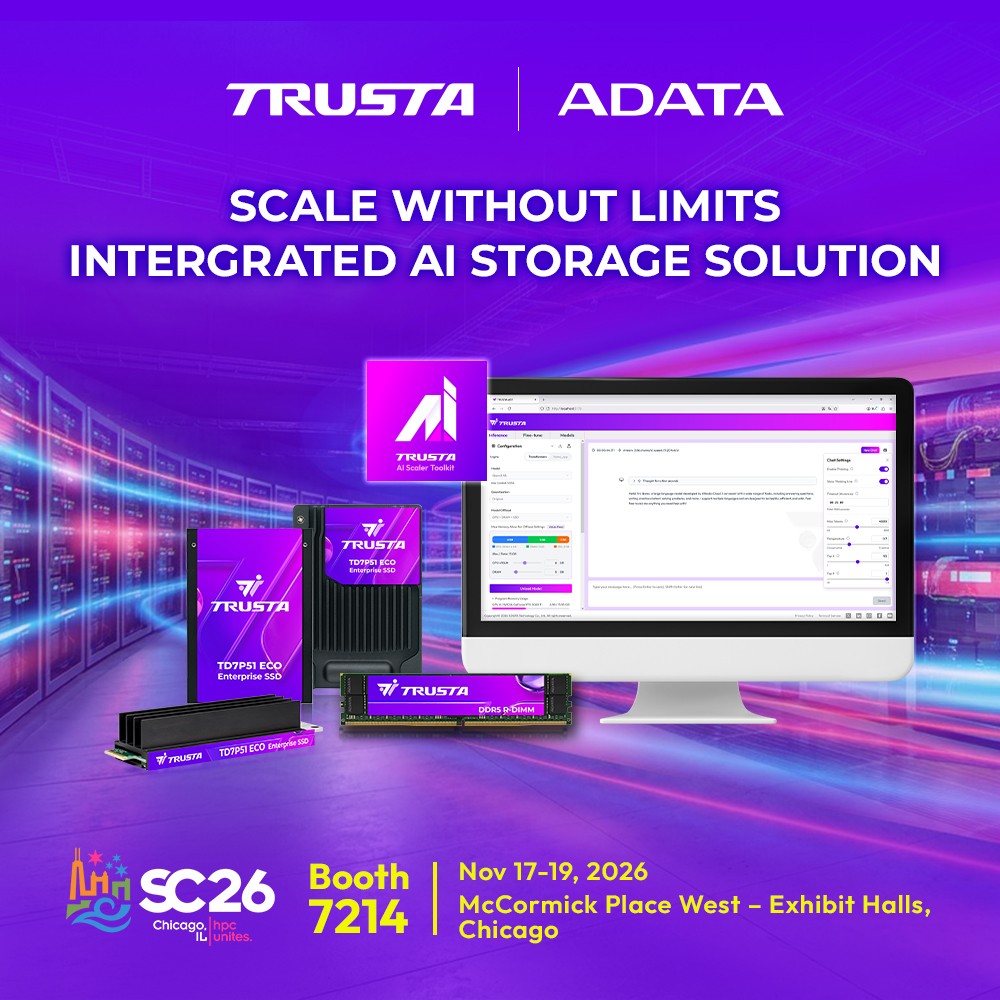
A TRUSTA, marca de
soluções de armazenamento corporativo da ADATA — líder no segmento de memórias
—, faz hoje sua estreia na SuperComputing 2026 (SC26), o principal evento
mundial dedicado à computação de alto desempenho. A edição deste ano da SC26
deve reunir mais de 450 expositores e um público superior a 18.000
participantes. Com o objetivo de auxiliar empresas a escalar a IA de forma
eficiente, a TRUSTA apresenta soluções que integram software, memória e
armazenamento. Entre os destaques está o kit de ferramentas “AI
Scaler” aprimorado, que utiliza o recurso de offloading de cache KV (do vLLM) para expandir
a memória de trabalho da IA, a estendendo da GPU para a DRAM e para os SSDs
corporativos da TRUSTA. Contextos longos são recarregados a partir do SSD, em
vez de serem reprocessados, o que reduz significativamente o tempo de espera
pelas respostas e permite que empresas implementem IA em infraestrutura própria
(on-premises) com
custos menores e recursos de GPU limitados. O kit de ferramentas também integra
o mecanismo de inferência Strata com aceleração Intel® AMX, aumentando a
velocidade de processamento de prompts (prefill)
em até 25%*.
Kit de ferramentas AI Scaler aprimorado: transferência de
KV cache do vLLM para SSD em aplicações de IA corporativa
À
medida que a IA transita do treinamento de modelos para a inferência, a demanda
por armazenamento cresce rapidamente. Segundo a Counterpoint Research, os SSDs
corporativos representaram 48% das remessas globais de capacidade de memória
flash NAND no segundo trimestre de 2026 — quase o dobro dos 26% registrados um
ano antes. Durante a inferência, um LLM mantém um “KV cache” (cache
de chaves e valores) de cada token processado; documentos extensos, conversas
com múltiplas interações e agentes de IA fazem com que esse cache exceda
rapidamente a capacidade da memória da GPU. Quando os dados são removidos da
memória da GPU, precisam ser recalculados, o que gera tempo de espera para o
usuário. O kit de ferramentas AI Scaler aprimorado integra o vLLM — mecanismo
de código aberto amplamente utilizado para a execução de IA em ambientes
corporativos — e distribui o KV cache em três níveis: memória da GPU (para
requisições ativas), DRAM (como um cache de alta velocidade) e SSDs
corporativos PCIe Gen5 da TRUSTA (uma camada de grande capacidade e baixo custo
que mantém os dados mesmo após reinicializações). Testes internos da TRUSTA
demonstram:
- Processamento muito mais rápido para documentos
extensos: documentos longos são
recarregados a partir do SSD em vez de serem recalculados, reduzindo
significativamente o tempo de espera até a resposta da IA; - Contexto preservado após reinicializações: após o reinício de um servidor, as conversas podem ser
retomadas a partir do KV cache armazenado no SSD, eliminando a necessidade
de recálculo do zero.
O
kit de ferramentas oferece, ainda, uma experiência centralizada: instalação com
um único clique, suporte a diversos modelos e mecanismos de inferência (vLLM,
llama.cpp e Strata), além de uma interface única para alocar recursos de GPU,
DRAM e SSD, ajustar parâmetros e testar modelos.
Strata com Intel® AMX: processamento de prompts até 25%
mais rápido
Para
implementações específicas que exigem a acomodação de modelos de grande porte
em uma memória de GPU limitada — utilizando, de forma eficiente, a DRAM e o SSD
—, o kit de ferramentas inclui o mecanismo leve Strata. Em processadores Intel®
Xeon®, a tecnologia Intel® AMX permite que a CPU processe os dados do modelo
diretamente na DRAM, acelerando o processamento de prompts em até 25%*.
SSD corporativo de alto desempenho e DDR5 R-DIMM:
fortalecendo a infraestrutura de IA
Além
do AI Scaler Toolkit, a TRUSTA apresenta SSDs corporativos PCIe Gen5 e módulos
DDR5 R-DIMM. Esses produtos de memória e armazenamento — de alto desempenho,
grande capacidade e eficiência energética — atendem às diversas necessidades de
servidores de IA e ambientes de computação de alto desempenho (HPC):
- SSD corporativo PCIe Gen5 (modelos TD7P51 ECO / T7P5): capacidades de até 15,36 TB nos formatos padrão U.2,
E1.S e E3.S, com uma resistência (endurance)
de até 3 DWPD. A tecnologia Flexible Data Placement (FDP) aprimora a
eficiência do armazenamento e prolonga a vida útil da unidade. Com um
consumo de energia inferior a 20W e uma eficiência energética 1,7 vez
superior à de produtos equivalentes, esses SSDs ajudam data centers a
reduzir o consumo de energia, alinhando-se à tendência global de data
centers mais sustentáveis; - DDR5 R-DIMM corporativo: velocidades de até 6.400 MT/s e capacidades de até 128
GB por módulo. O recurso ECC integrado detecta e corrige automaticamente
erros de dados, garantindo a estabilidade e a confiabilidade dos
servidores de IA sob cargas de trabalho intensas e contínuas.
“À
medida que a adoção de IA no ambiente corporativo continua a crescer, a
integração eficaz de recursos de computação, memória e armazenamento torna-se
fundamental para otimizar a eficiência da implementação de IA e controlar
custos”, afirma a TRUSTA. As empresas não precisam continuar comprando
GPUs caras para adotar a IA. Ao fazer um uso mais eficiente de CPUs, memória e
SSDs, elas conseguem executar a IA com mais rapidez e melhor custo-benefício.
Com o AI Scaler Toolkit aprimorado, além de SSDs de classe empresarial e
tecnologias de memória, a TRUSTA ajuda as empresas a aproveitar ao máximo o
hardware que já possuem e a criar ambientes de computação para IA mais
flexíveis, eficientes e escaláveis, permitindo que expandam a IA de maneira
eficiente.
*Notas de teste: com base
em testes internos da TRUSTA realizados em novembro de 2026, comparando a
versão do Strata (integrada ao AI Scaler Toolkit) habilitada para AMX com a
versão original (upstream)
Strata v0.2.11. Plataforma de teste: processador Intel® Xeon® w5-3535X com uma
GPU NVIDIA RTX 6000 Ada, executando um modelo de linguagem (LLM) do tipo
Mixture-of-Experts (MoE). Apenas a etapa de prefill
(pré-processamento/preenchimento inicial) foi medida. Cada teste foi realizado
pelo menos três vezes, sendo apresentados os resultados medianos. Com uma
entrada única de aproximadamente 8 mil tokens, a velocidade aumentou cerca de
11%. Em conversas de múltiplos turnos, com cerca de 4 mil novos tokens por
turno, a velocidade aumentou aproximadamente 25%. Para entradas únicas acima de
cerca de 12 mil tokens, não houve diferença significativa. O desempenho real
varia de acordo com a configuração de hardware, o modelo e o tamanho da
entrada.
Informações sobre o evento
Evento: Supercomputing 2026 (SC26)
Data: 17 a 19 de novembro de 2026
Local: McCormick Place West – Pavilhões de Exposição,
Chicago, EUA
Estande nº: 7214
Janaina Leme
11 5091-7838
[email protected]
www.singcomunica.com.br